VedioDownload
视频下载,音频转译,洗稿一步到位。
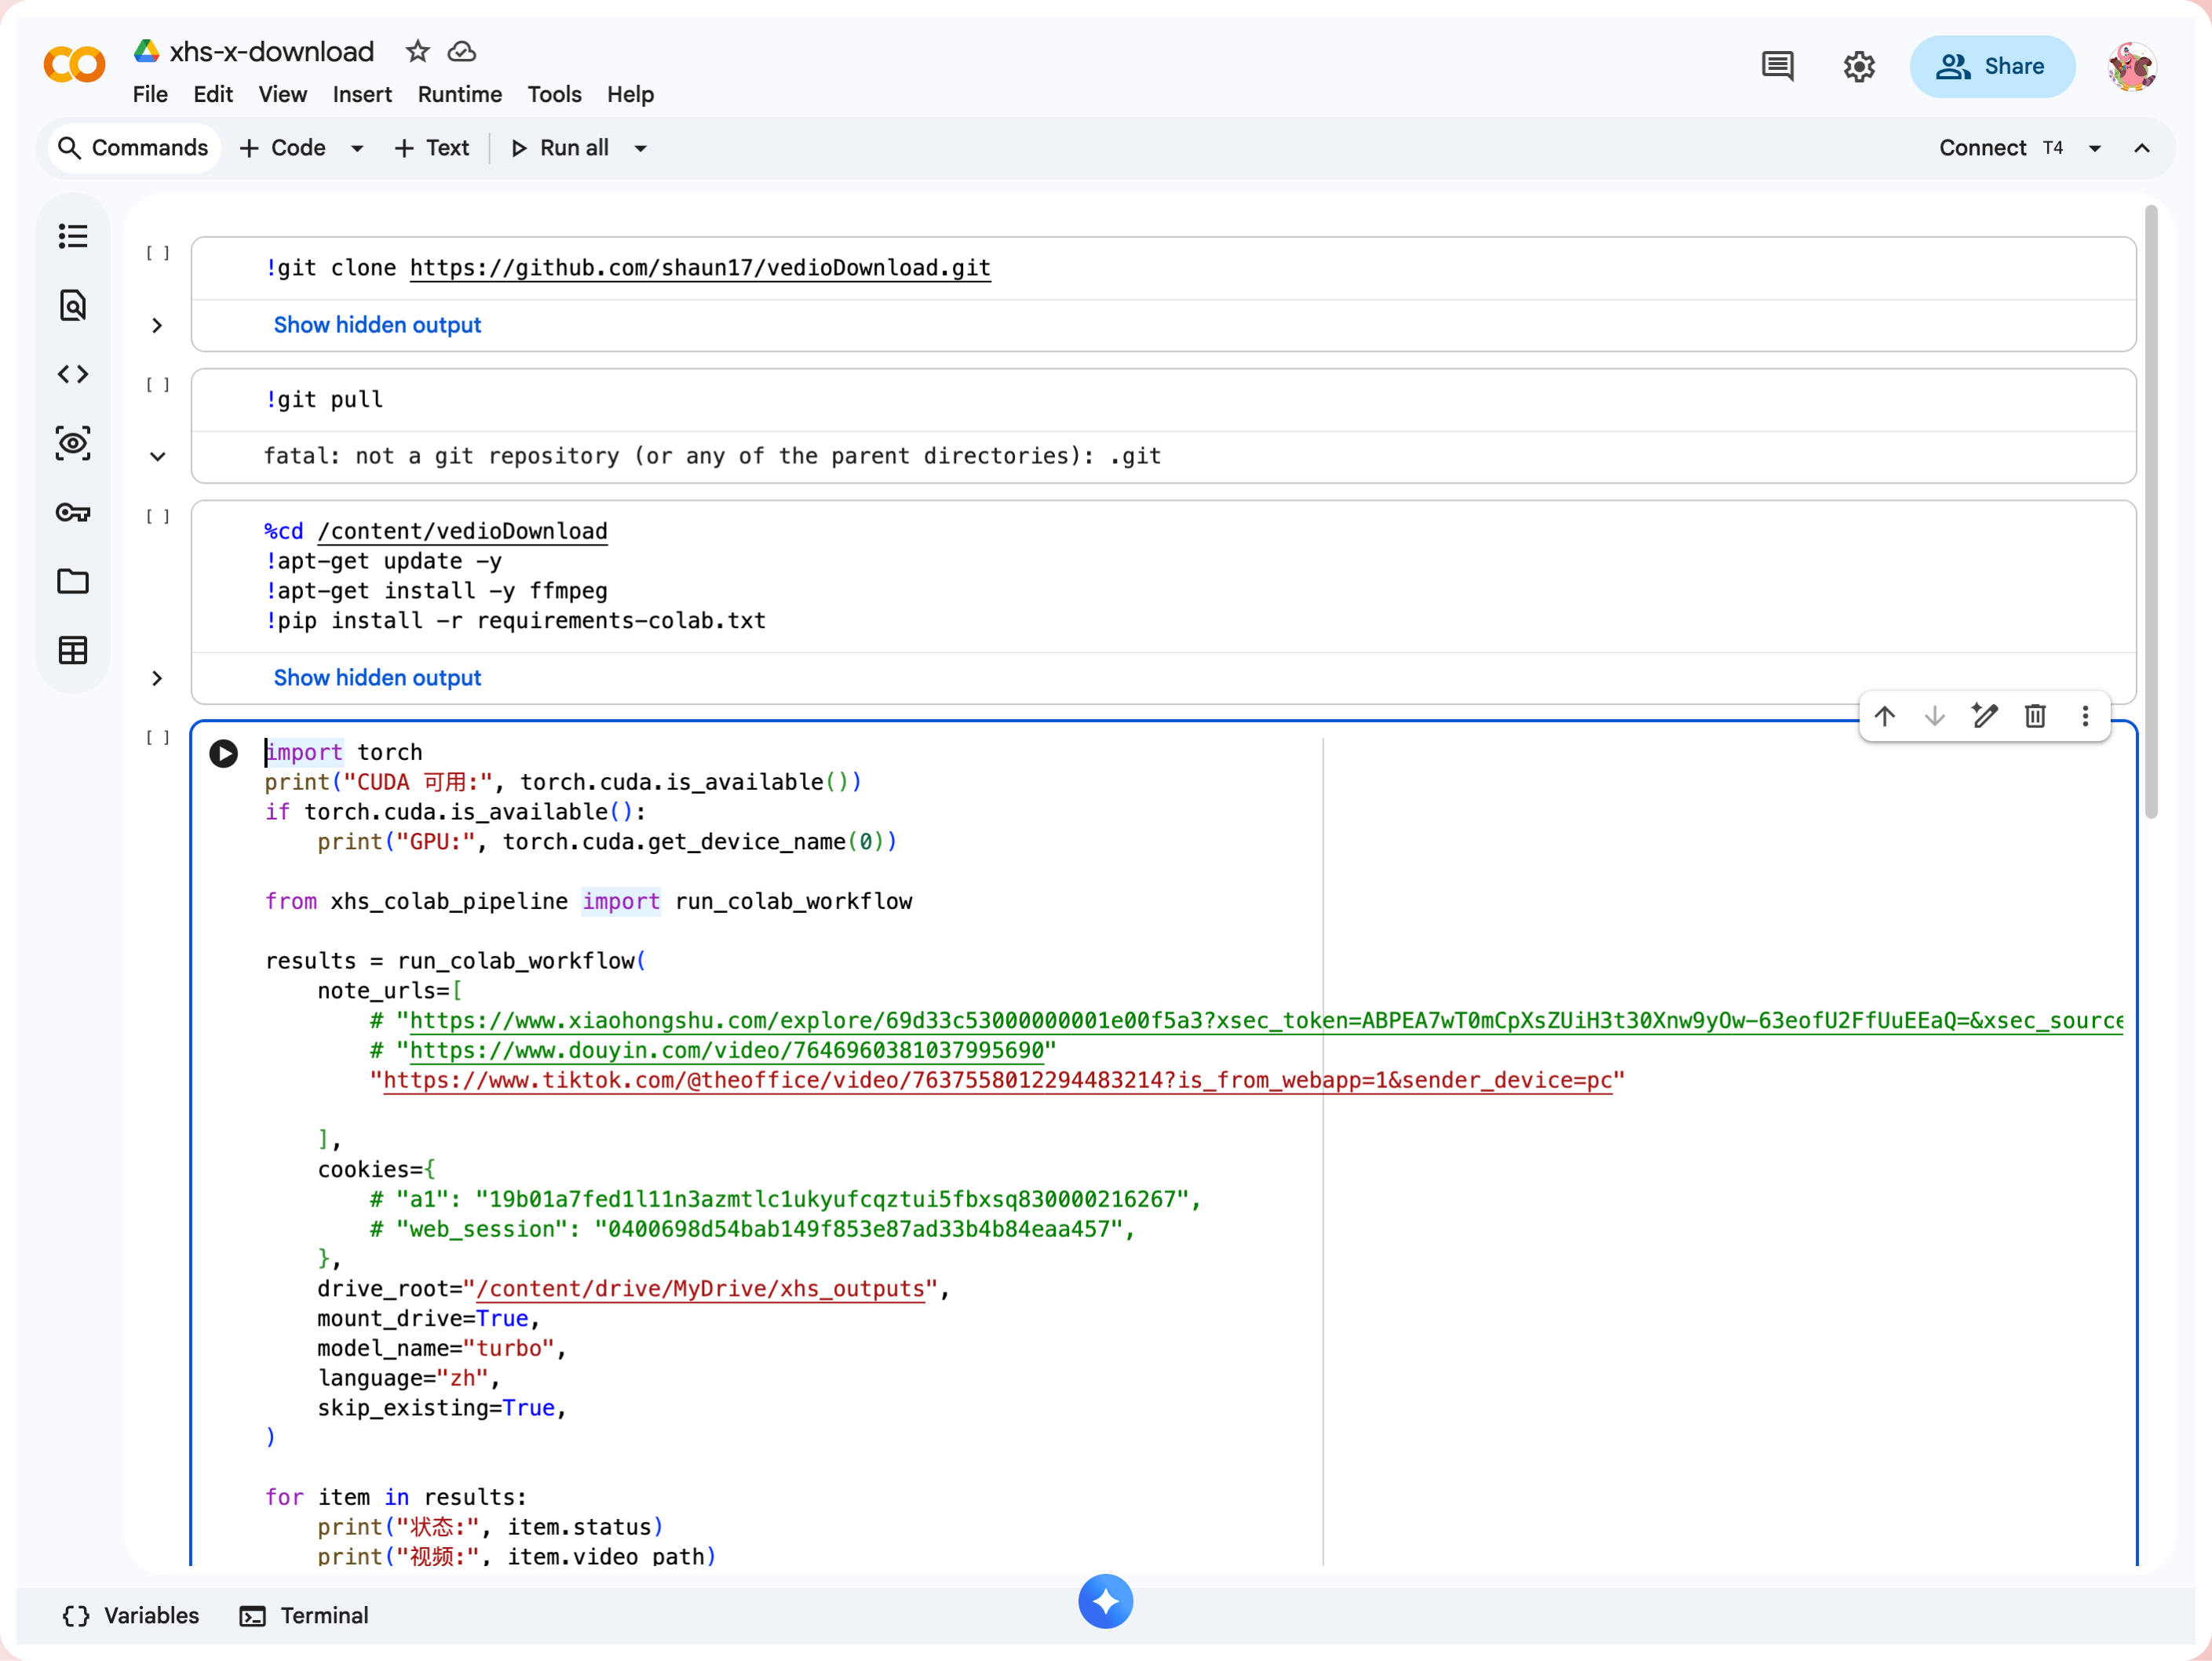
工程介绍
这是一个用于个人媒体归档的视频下载和语音转文字工具。
输入一个或一批已获授权的视频链接后,它可以识别小红书、抖音、TikTok 和其他受 yt-dlp 支持的公开页面,下载视频或音频,并按需把语音转成文字。最终会把媒体文件、文稿和完整信息保存到本地或 Google Drive,方便后续整理和使用。
- 多平台下载: 根据链接自动选择合适的下载方式。
- 自动转录: 使用 Whisper 把视频中的语音转换成文字。
- 批量处理: 单条任务失败不会影响其他链接继续执行。
- 可恢复执行: 已经完成的任务会自动跳过,不完整的任务会重新处理。
实现方案
数据怎么处理
- 识别任务: 先清理重复链接、判断所属平台,并根据视频 ID 或链接生成稳定的任务编号。
- 选择下载方式: 小红书和抖音使用专用解析器,TikTok 和其他平台交给 yt-dlp;下载时会选择合适的编码、分辨率和媒体格式。
- 准备音频: 视频下载完成后,通过 FFmpeg 提取音频;部分平台会直接单独下载音频,减少再次转换造成的问题。
- 语音转文字: 使用 faster-whisper 转录。有 GPU 时使用 GPU 加速,没有 GPU 时自动切换到 CPU。
- 结构化保存: 每条任务分别保存媒体文件、
transcript.txt文稿和metadata.json元数据,并可直接写入 Google Drive。
结果怎么判断
- 完整任务: 媒体文件不为空、文稿不为空,并且元数据中的文稿与实际文稿一致,三项都满足才算完成。
- 执行状态: 每条链接都会得到
success、skipped或failed状态;批量执行时互不影响。 - 媒体信息: 记录平台、原始链接、解析后链接、编码、分辨率、帧率、码率、格式和文件大小。
- 转录信息: 记录识别语言、语言可信度、所用模型、运行设备以及每段文字的开始和结束时间。
- 重复运行: 完整结果直接跳过;只要缺少媒体、文稿或有效元数据,就会重新执行,避免留下半成品。